O que aconteceu
Em 5 de outubro de 2026, a OpenAI publicou o anúncio Our approach to EU text provenance rules e explicou como pretende cumprir as regras europeias de transparência para texto gerado por IA. Nas próximas semanas, a empresa adicionará uma marca d’água invisível às respostas elegíveis do ChatGPT e do Codex na União Europeia, em todos os planos e sem opção de desligamento para o usuário final.
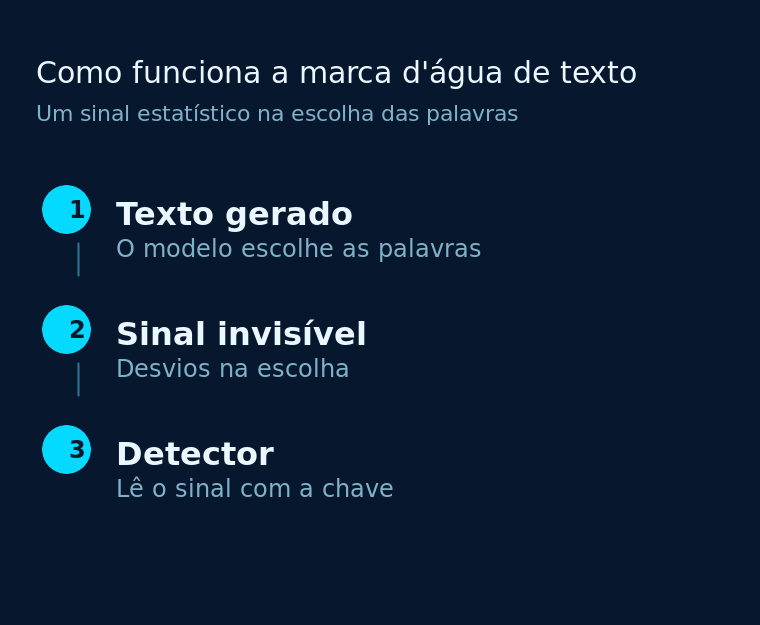
A tecnologia se chama textGrain e não insere símbolo visível: ela molda sutilmente a escolha de palavras do modelo, deixando um padrão estatístico que apenas um detector com a chave correta enxerga. Como o sinal está embutido no próprio texto, ele viaja junto quando o conteúdo é copiado e colado em outro lugar.
O ponto que interessa a quem constrói software é outro: desde o mesmo dia, clientes da API em qualquer país podem ativar a marca d’água por adesão voluntária em modelos selecionados — por padrão, ela continua desligada. E o acesso ao detector será restrito, no início, a pesquisadores e organizações especializadas aprovados por candidatura.
Por que isso está acontecendo
A raiz da mudança é o Código de Boas Práticas da UE sobre conteúdo gerado por IA, que operacionaliza o artigo 50 do AI Act (Regulamento UE 2024/1689). O texto exige que provedores de IA generativa marquem suas saídas — áudio, imagem, vídeo e texto — em formato legível por máquina e detectável como artificiais. As obrigações de transparência passaram a valer em 2 de agosto de 2026, conforme a Comissão Europeia.
Para dar previsibilidade ao setor, a Comissão publicou o mesmo código em 10 de junho de 2026, com adesão voluntária. Segundo a Comissão Europeia, cerca de 190 organizações já haviam aderido até o fim de julho de 2026 — OpenAI, Anthropic, Google, Meta e Microsoft entre elas.
A Anthropic já marca todo o texto do Claude globalmente, inclusive para quem acessa os modelos pela API; a OpenAI escolheu o caminho oposto, deixando a marca d’água desligada por padrão na API. O texto é o formato mais difícil de marcar: palavras podem ser reescritas, traduzidas e cortadas sem deixar rastro, o que explica a abordagem em etapas.
O que isso muda para uma PME brasileira
Mesmo sem operar na Europa, o movimento chega ao Brasil por dois caminhos. O primeiro é a API: quem constrói produto sobre a OpenAI ganha um botão de transparência que antes não existia. O segundo é cultural — a expectativa de que conteúdo gerado por IA seja identificável está virando padrão global.
O Brasil é um adotante intenso. Um levantamento da Bain & Company com a Microsoft aponta IA generativa presente em 95% das empresas brasileiras, mas só 34% têm política específica de proteção de dados para IA (Agência Dino). Do lado do consumidor, a pesquisa CX Trends 2026, da Zendesk, mostra 69% dos brasileiros usando mais IA no último ano e 95% pedindo transparência sobre como ela chega às respostas.
No plano regulatório, o PL 2338/2023 — o marco legal da IA no Brasil — foi aprovado pelo Senado em dezembro de 2024 e segue em análise na Câmara dos Deputados. Temas de rotulagem e rastreabilidade de conteúdo sintético devem entrar nessa discussão, e a ANPD tende a ganhar papel central na fiscalização. Na prática, para a PME, documentar onde a IA entra no processo deixa de ser detalhe e passa a ser defesa: se um cliente ou auditor perguntar quem escreveu aquele texto, a empresa precisa ter resposta.
Onde faz sentido usar
- Conteúdo institucional que informa o público — relatórios, comunicados e materiais sobre temas de interesse coletivo são exatamente o alvo do artigo 50(4); rotular antes de alguém cobrar reduz risco reputacional.
- Atendimento e produto digital — ao expor um chatbot, avisar que o usuário fala com IA já vale na UE e tende a virar referência; um texto de interface claro resolve mais que qualquer selo.
- Agências e times de conteúdo — quem entrega texto para clientes europeus precisa decidir se ativa a marca d’água na API e como isso aparece no contrato.
- Governança e auditoria interna — registrar o uso de IA e das ferramentas de detecção ajuda a montar a trilha que a ANPD e o PL 2338 devem exigir.
Riscos e limites
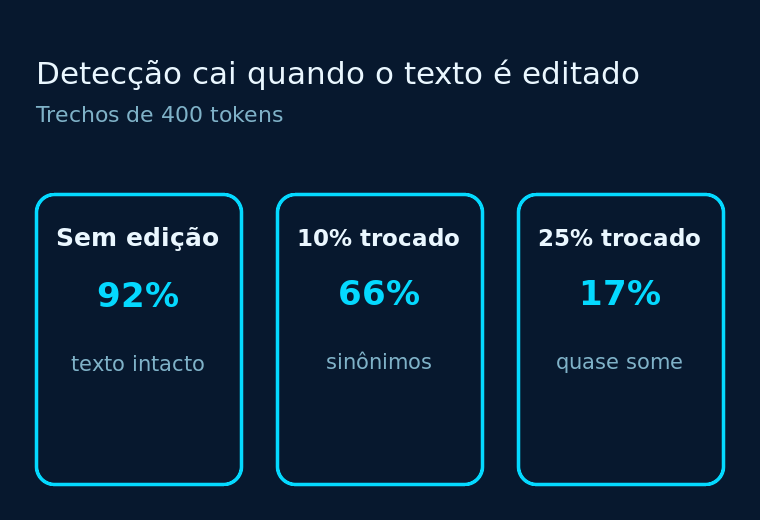
A própria OpenAI é explícita sobre as fraquezas da tecnologia. Em um alvo de 1% de falsos positivos, o detector encontrou a marca em cerca de 80% de trechos de 200 tokens e em 95% de trechos de 400 tokens (OpenAI). Basta trocar 10% das palavras por sinônimos para a detecção cair de 92% para 66%; com 25% substituído, desaba para 17%. Textos curtos, respostas de matemática e traduções são ainda mais difíceis de flagrar.
Transformar isso em regra automática de negócio é o erro clássico. A empresa deixa claro que a marca d’água não prova autoria, não identifica o usuário e não verifica se o conteúdo é verdadeiro. E, sobretudo, a ausência de marca não prova autoria humana. Usar detector de IA como prova de plágio ou como filtro automático de publicação tende a gerar injustiça e retrabalho.
O que avaliar antes de implementar
- Exposição ao AI Act — sua empresa é provedora, que marca a saída, ou responsável pela publicação, que rotula o conteúdo? A maioria das PMEs que apenas usam ferramentas de terceiros cai no segundo caso.
- Decisão sobre o opt-in na API — ativar a marca d’água em modelos selecionados é escolha de produto. Avalie o efeito no custo, na experiência do usuário e na sua capacidade de auditar o resultado.
- Governança do uso de IA — mapeie onde a IA gera texto hoje, quem revisa e como isso fica registrado. Sem esse inventário, rotulagem vira adivinhação.
- Limite de confiança no detector — trate a detecção como indício, nunca como veredito. Defina quem pode acessar o detector e como um resultado é comunicado.
Fontes
- OpenAI — Our approach to EU text provenance rules — acesso em 6 out. 2026
- Comissão Europeia — Code of Practice on Transparency of AI-generated Content — acesso em 6 out. 2026
- TechCrunch — OpenAI will start watermarking ChatGPT’s text in the EU — acesso em 6 out. 2026
- The Decoder — OpenAI will watermark ChatGPT text in the EU — acesso em 6 out. 2026
- Câmara dos Deputados — PL 2338/2023 — acesso em 6 out. 2026
A informação foi verificada em pelo menos duas fontes independentes. Trechos citados estão entre aspas e atribuídos à fonte original.
Conclusão
A marca d’água de texto da OpenAI é menos um selo e mais um aviso: o conteúdo gerado por IA está entrando na era da rastreabilidade, mesmo que a tecnologia ainda erre. Para a PME brasileira, a decisão útil hoje não é esperar o AI Act chegar, e sim saber onde a IA entra no seu conteúdo e como isso fica documentado. Quem monta essa base primeiro transforma obrigação em vantagem.
Sua empresa já sabe onde a IA entra no conteúdo que publica? A Canis ajuda a estruturar o uso de IA, automação e governança de conteúdo para o seu negócio. Fale sobre inteligência artificial e automação →